Domain irtc.de kaufen?
Wir ziehen mit dem Projekt
irtc.de um.
Sind Sie am Kauf der Domain
irtc.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain irtc.de kaufen?
Was sind effiziente Methoden zur Namensauflösung in großen Datensätzen?
Effiziente Methoden zur Namensauflösung in großen Datensätzen sind Hashing-Algorithmen, die den Namen in einen eindeutigen Hash-Wert umwandeln, um schnelle Suchvorgänge zu ermöglichen. Indexstrukturen wie Bäume oder Hash-Tabellen können verwendet werden, um den Zugriff auf die Namen zu optimieren. Parallelisierungstechniken wie MapReduce können eingesetzt werden, um die Verarbeitung großer Datensätze zu beschleunigen. **
Was sind mögliche Gründe für Nichtübereinstimmungen zwischen verschiedenen Datensätzen?
Mögliche Gründe für Nichtübereinstimmungen zwischen verschiedenen Datensätzen können menschliche Fehler bei der Dateneingabe, unterschiedliche Datenformate oder -strukturen sowie fehlende oder inkorrekte Daten sein. Auch können technische Probleme wie Datenverlust oder -korruption zu Nichtübereinstimmungen führen. Schließlich können auch unterschiedliche Zeitpunkte der Datenerfassung oder -aktualisierung zu Abweichungen zwischen den Datensätzen führen. **
Ähnliche Suchbegriffe für Datensätzen
Top-Angebote
Produkte zum Begriff Datensätzen:
-
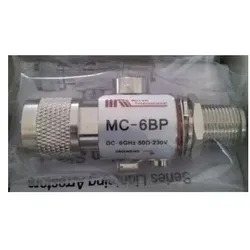
Allnet MC-6BP Netzwerk-Antennen-Zubehör (Netzwerk Zubehör), Zubehör NetzwerkDas Gerät verfügt über eine Schott N-Buchse mit einer Gummi-O-Ring-Dichtung zur Montage durch eine Gehäusewand oder über die optionale Montagebügel aus Edelstahl. Aufgrund seiner überlegenen HF-Leistung ist dieses Gerät ideal für IEEE 802.11a und andere 5,2-5,8 GHz ISM und UNII Anwendungen sowie 3,5 GHz WLL-Anwendungen. Beide Ports an diesem Gerät sind gleichermassen geschützt. Dies bietet Schutz, egal in welche Richtung es installiert ist. Hauptmerkmale: Produktfarbe grau, Gehäusematerial Messing, Anzahl 1. Gewicht & Abmessungen: Breite 68 mm, Tiefe 23 mm, Höhe 31 mm, Gewicht 110 g.48,19 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Wie können Datenanalysten mithilfe von statistischen Methoden und Software-Tools die Informationen in umfangreichen Datensätzen extrahieren und interpretieren?
Datenanalysten können mithilfe von statistischen Methoden Muster und Trends in den Daten erkennen. Sie nutzen Software-Tools wie R oder Python, um komplexe Analysen durchzuführen. Durch die Extraktion und Interpretation von Informationen können sie fundierte Entscheidungen treffen und Einblicke gewinnen. **
-
Welche Methoden werden in der Datenbankverwaltung verwendet, um die Integrität und Sicherheit von Datensätzen zu gewährleisten?
In der Datenbankverwaltung werden verschiedene Methoden verwendet, um die Integrität und Sicherheit von Datensätzen zu gewährleisten. Dazu gehören die Implementierung von Zugriffsrechten und Benutzerrollen, um sicherzustellen, dass nur autorisierte Benutzer auf die Datenbank zugreifen können. Des Weiteren werden Verschlüsselungstechniken eingesetzt, um sensible Daten vor unbefugtem Zugriff zu schützen. Zudem werden regelmäßige Backups erstellt, um im Falle eines Datenverlusts die Wiederherstellung der Daten zu ermöglichen. Darüber hinaus werden in der Datenbankverwaltung auch Integritätsconstraints wie Primär- und Fremdschlüssel verwendet, um sicherzustellen, dass die Datenbankkonsistenz gewahrt bleibt. **
-
Was ist der Unterschied zwischen komprimierten Daten und komprimierten Datensätzen?
Komprimierte Daten beziehen sich auf einzelne Dateien oder Informationen, die durch einen Komprimierungsalgorithmus verkleinert wurden, um Speicherplatz zu sparen. Komprimierte Datensätze hingegen beziehen sich auf eine Sammlung von Daten, die als Ganzes komprimiert wurden, um Platz zu sparen und die Übertragungseffizienz zu verbessern. Ein komprimierter Datensatz kann aus mehreren komprimierten Dateien oder Datenbeständen bestehen, die zusammengefasst wurden. **
-
Was sind die effektivsten Methoden zur Datenreduktion in großen Datensätzen?
Die effektivsten Methoden zur Datenreduktion in großen Datensätzen sind die Entfernung von redundanter Information, die Anwendung von Kompressionsalgorithmen und die Auswahl relevanter Merkmale. Durch diese Maßnahmen kann die Datenmenge reduziert werden, ohne dabei wichtige Informationen zu verlieren. Dadurch wird die Verarbeitungsgeschwindigkeit verbessert und der Speicherplatzbedarf verringert. **

"Was sind die effektivsten Methoden zur Datenreduktion in großen Datensätzen?"
Die effektivsten Methoden zur Datenreduktion in großen Datensätzen sind die Entfernung von redundanter Information, die Anwendung von Dimensionalitätsreduktionstechniken wie PCA und die Nutzung von Clustering-Algorithmen zur Identifizierung von repräsentativen Datenpunkten. Es ist auch wichtig, Ausreißer zu identifizieren und zu entfernen, um die Qualität der Daten zu verbessern und die Effizienz von Analysen zu steigern. Letztendlich sollten die gewählten Methoden darauf abzielen, die Datenmenge zu reduzieren, ohne dabei wichtige Informationen zu verlieren. **
Wie können Abweichungen in großen Datensätzen erkannt und interpretiert werden?
Abweichungen in großen Datensätzen können durch statistische Analysen wie Ausreißererkennung und Clusteranalyse identifiziert werden. Zudem können Data-Mining-Techniken wie Anomalieerkennung und Mustererkennung eingesetzt werden, um ungewöhnliche Muster oder Trends zu erkennen. Die Interpretation der Abweichungen erfordert in der Regel Fachwissen und Kontextwissen, um die Ursachen und Auswirkungen der Abweichungen zu verstehen. **
Top-Angebote
Produkte zum Begriff Datensätzen:
-
Was sind effiziente Methoden zur Namensauflösung in großen Datensätzen?
Effiziente Methoden zur Namensauflösung in großen Datensätzen sind Hashing-Algorithmen, die den Namen in einen eindeutigen Hash-Wert umwandeln, um schnelle Suchvorgänge zu ermöglichen. Indexstrukturen wie Bäume oder Hash-Tabellen können verwendet werden, um den Zugriff auf die Namen zu optimieren. Parallelisierungstechniken wie MapReduce können eingesetzt werden, um die Verarbeitung großer Datensätze zu beschleunigen. **
-
Was sind mögliche Gründe für Nichtübereinstimmungen zwischen verschiedenen Datensätzen?
Mögliche Gründe für Nichtübereinstimmungen zwischen verschiedenen Datensätzen können menschliche Fehler bei der Dateneingabe, unterschiedliche Datenformate oder -strukturen sowie fehlende oder inkorrekte Daten sein. Auch können technische Probleme wie Datenverlust oder -korruption zu Nichtübereinstimmungen führen. Schließlich können auch unterschiedliche Zeitpunkte der Datenerfassung oder -aktualisierung zu Abweichungen zwischen den Datensätzen führen. **
-
Wie können Datenanalysten mithilfe von statistischen Methoden und Software-Tools die Informationen in umfangreichen Datensätzen extrahieren und interpretieren?
Datenanalysten können mithilfe von statistischen Methoden Muster und Trends in den Daten erkennen. Sie nutzen Software-Tools wie R oder Python, um komplexe Analysen durchzuführen. Durch die Extraktion und Interpretation von Informationen können sie fundierte Entscheidungen treffen und Einblicke gewinnen. **
-
Welche Methoden werden in der Datenbankverwaltung verwendet, um die Integrität und Sicherheit von Datensätzen zu gewährleisten?
In der Datenbankverwaltung werden verschiedene Methoden verwendet, um die Integrität und Sicherheit von Datensätzen zu gewährleisten. Dazu gehören die Implementierung von Zugriffsrechten und Benutzerrollen, um sicherzustellen, dass nur autorisierte Benutzer auf die Datenbank zugreifen können. Des Weiteren werden Verschlüsselungstechniken eingesetzt, um sensible Daten vor unbefugtem Zugriff zu schützen. Zudem werden regelmäßige Backups erstellt, um im Falle eines Datenverlusts die Wiederherstellung der Daten zu ermöglichen. Darüber hinaus werden in der Datenbankverwaltung auch Integritätsconstraints wie Primär- und Fremdschlüssel verwendet, um sicherzustellen, dass die Datenbankkonsistenz gewahrt bleibt. **
Ähnliche Suchbegriffe für Datensätzen
-
Allnet MC-6BP Netzwerk-Antennen-Zubehör (Netzwerk Zubehör), Zubehör NetzwerkDas Gerät verfügt über eine Schott N-Buchse mit einer Gummi-O-Ring-Dichtung zur Montage durch eine Gehäusewand oder über die optionale Montagebügel aus Edelstahl. Aufgrund seiner überlegenen HF-Leistung ist dieses Gerät ideal für IEEE 802.11a und andere 5,2-5,8 GHz ISM und UNII Anwendungen sowie 3,5 GHz WLL-Anwendungen. Beide Ports an diesem Gerät sind gleichermassen geschützt. Dies bietet Schutz, egal in welche Richtung es installiert ist. Hauptmerkmale: Produktfarbe grau, Gehäusematerial Messing, Anzahl 1. Gewicht & Abmessungen: Breite 68 mm, Tiefe 23 mm, Höhe 31 mm, Gewicht 110 g.48,19 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
LogiLink Prüfen (Netzwerk Kupplung, Netzwerk Zubehör), Zubehör NetzwerkLogiLink LWL-Verbinder mit Flansch eignen sich ideal für den Einbau in LWL-Patchpanels und Verteiler mit Schraubbefestigung. Sie zeichnen sich durch eine hohe Lebensdauer und Passgenauigkeit aus. Alle LogiLink LWL-Kupplungen und -Steckverbinder entsprechen den aktuell gültigen Normen.30,32 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
IT-SicherheitIT-Sicherheit , Technologien und Best Practices für die Umsetzung im Unternehmen , Sport-Gewindefahrwerk > Sportfederung , Auflage: 2., überarbeitete Auflage, Erscheinungsjahr: 20241011, Produktform: Leinen, Inhalt/Anzahl: 1, Inhalt/Anzahl: 1, Redaktion: Lang, Michael~Löhr, Hans, Auflage: 24002, Auflage/Ausgabe: 2., überarbeitete Auflage, Seitenzahl/Blattzahl: 444, Keyword: Cyber Security; Cyberabwehr; Datenschutz; Hacking; ISO 27001; IT-Infrastruktur; IT-Sicherheit; Informationssicherheit; Risikoanalyse, Fachschema: Datensicherheit / Netz~EDV / Theorie / Sicherheit~Hacker (EDV)~Datenschutz~Datensicherheit~Datensicherung~Sicherheit / Datensicherheit, Fachkategorie: Computerkriminalität, Hacking~Netzwerksicherheit, Warengruppe: HC/Datenkommunikation/Netze/Mailboxen, Fachkategorie: Datenschutz, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Sender’s product category: BUNDLE, Verlag: Hanser Fachbuchverlag, Verlag: Hanser Fachbuchverlag, Verlag: Hanser, Carl, Verlag GmbH & Co. KG, Produktverfügbarkeit: 02, Länge: 246, Breite: 180, Höhe: 31, Gewicht: 948, Produktform: Gebunden, Genre: Mathematik/Naturwissenschaften/Technik/Medizin, Genre: Mathematik/Naturwissenschaften/Technik/Medizin, Vorgänger: 2823581,39,99 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Was ist der Unterschied zwischen komprimierten Daten und komprimierten Datensätzen?
Komprimierte Daten beziehen sich auf einzelne Dateien oder Informationen, die durch einen Komprimierungsalgorithmus verkleinert wurden, um Speicherplatz zu sparen. Komprimierte Datensätze hingegen beziehen sich auf eine Sammlung von Daten, die als Ganzes komprimiert wurden, um Platz zu sparen und die Übertragungseffizienz zu verbessern. Ein komprimierter Datensatz kann aus mehreren komprimierten Dateien oder Datenbeständen bestehen, die zusammengefasst wurden. **
-
Was sind die effektivsten Methoden zur Datenreduktion in großen Datensätzen?
Die effektivsten Methoden zur Datenreduktion in großen Datensätzen sind die Entfernung von redundanter Information, die Anwendung von Kompressionsalgorithmen und die Auswahl relevanter Merkmale. Durch diese Maßnahmen kann die Datenmenge reduziert werden, ohne dabei wichtige Informationen zu verlieren. Dadurch wird die Verarbeitungsgeschwindigkeit verbessert und der Speicherplatzbedarf verringert. **
-
"Was sind die effektivsten Methoden zur Datenreduktion in großen Datensätzen?"
Die effektivsten Methoden zur Datenreduktion in großen Datensätzen sind die Entfernung von redundanter Information, die Anwendung von Dimensionalitätsreduktionstechniken wie PCA und die Nutzung von Clustering-Algorithmen zur Identifizierung von repräsentativen Datenpunkten. Es ist auch wichtig, Ausreißer zu identifizieren und zu entfernen, um die Qualität der Daten zu verbessern und die Effizienz von Analysen zu steigern. Letztendlich sollten die gewählten Methoden darauf abzielen, die Datenmenge zu reduzieren, ohne dabei wichtige Informationen zu verlieren. **
-
Wie können Abweichungen in großen Datensätzen erkannt und interpretiert werden?
Abweichungen in großen Datensätzen können durch statistische Analysen wie Ausreißererkennung und Clusteranalyse identifiziert werden. Zudem können Data-Mining-Techniken wie Anomalieerkennung und Mustererkennung eingesetzt werden, um ungewöhnliche Muster oder Trends zu erkennen. Die Interpretation der Abweichungen erfordert in der Regel Fachwissen und Kontextwissen, um die Ursachen und Auswirkungen der Abweichungen zu verstehen. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.